动手写一个 Agent
用 Pi 作为模板,拆解,消化,然后随心所欲做一个 Agent 出来
怎么入门 Agent 开发?
自上而下的办法是用现有 Agent 对接各种系统。 自下而上的办法是写一个 Agent。
本文讲自下而上这个“Hard Way”,参考 Pi 源码写个 Coding Agent,然后跑 Benchmark 验证质量。 最终代码在 pi.mbt Github 仓库。
Agent 的核心是 Agent Loop,我们从核心开始。
Agent Loop
想想平时我们如何使用 Coding Agent:我们给它任务 (prompts),它用工具 (tools) 执行任务,然后给我们答复 (messages),这个过程就是 AgentLoop。
为什么叫 Loop 呢?这是它的内部实现特点,是为了让 Agent 能够使用工具而设计的一个东西,先不管,先把 AgentLoop 当一个黑盒过程函数 (Process)。 理解函数,可以先从输入、输出、副作用来理解。
pub async fn run_agent_loop(
  llm : &LLM,
  system_prompt : String,
  messages : Array[AgentMessage],
  tools : ArrayView[ToolDefinition],
  prompts : ArrayView[UserMessage],
  tool_executor~ : async (ToolCall, ToolExecUpdateCallback) -> ToolResult,
) -> LoopStopReason {
  ...
}- 输入有
llm模型,system_prompt系统指令,messages上下文,tools工具定义,prompts用户输入,还有tool_executor负责执行工具。 - 输出是新的过程消息,我们直接追加到
messages里。还有LoopStopReason说明 loop 停止是因为拿到模型最终回复,还是用户中断/系统错误。 - 副作用是
tool_executor执行工具产生的影响。
这些接口信息有点浅,我们要深入函数内部运作。
Agent Loop 阶段
可以把黑盒过程拆成更小的阶段分而治之。Pi 里会在每个阶段前后 emit event,很细致,我们拿 Pi 文档里的例子来看它的阶段设计。也能让外部“扩展”这个过程,就是在阶段之间插入 hook,这是 Pi 能灵活扩展的原因。
prompt("Read config.json")
├─ agent_start
├─ turn_start
├─ message_start/end  { userMessage }
├─ message_start      { assistantMessage with toolCall }
├─ message_update...
├─ message_end        { assistantMessage }
├─ tool_execution_start  { toolCallId, toolName, args }
├─ tool_execution_update { partialResult }           // If tool streams
├─ tool_execution_end    { toolCallId, result }
├─ message_start/end  { toolResultMessage }
├─ turn_end           { message, toolResults: [toolResult] }
│
├─ turn_start                                        // Next turn
├─ message_start      { assistantMessage }           // LLM responds to tool result
├─ message_update...
├─ message_end
├─ turn_end
└─ agent_end
这例子是用户让 Agent 读取一个配置文件 ("Read config.json")。
- 最外层叫 agent 阶段,也就是 AgentLoop。
- 第二层是 turn 阶段,就是 loop 循环里的一轮,所以一个 AgentLoop 可能有多个 turn。
- turn 里面是“叶子”,分为 message 阶段和 tool_execution 阶段。注意它们有 update 事件,说明 Pi 原生支持流式输出。
tool_execution 阶段好理解,就是执行工具的过程,例如 read 工具在读取配置文件,bash 工具在执行编译命令。
message 阶段比较复杂,因为里面包含了不同来源的消息,包括用户输入的 userMessage,LLM 生成的 assistantMessage,以及 chatbot 没有的,由带 toolCall 的 assistantMessage 触发的,工具执行结果 toolResultMessage。
pub(all) enum AgentMessage {
  User(UserMessage)
  Assistant(AssistantMessage)
  ToolResult(ToolResultMessage)
}
这里可以解释为什么叫 AgentLoop 了,因为我们要主动把 toolResultMessage 反馈给 LLM,让 LLM 继续生成,而后续过程又可能产生新的 toolResultMessage,构成循环。
也就是说 AgentLoop 最开始是由用户输入的 userMessage 触发 LLM 生成,后续则由 toolResultMessage 触发 LLM 生成。常见 Agent 还支持 Steering Message,也就是用户可以在 loop 中途插入新的 userMessage,所以循环开始后也可以被用户输入继续驱动。
所以 AgentLoop 其实是在支持了工具调用后,一个最直接的执行策略:把工具调用结果塞回去给 LLM,让 LLM 自己决定下一步要做什么,也就是 ReAct:
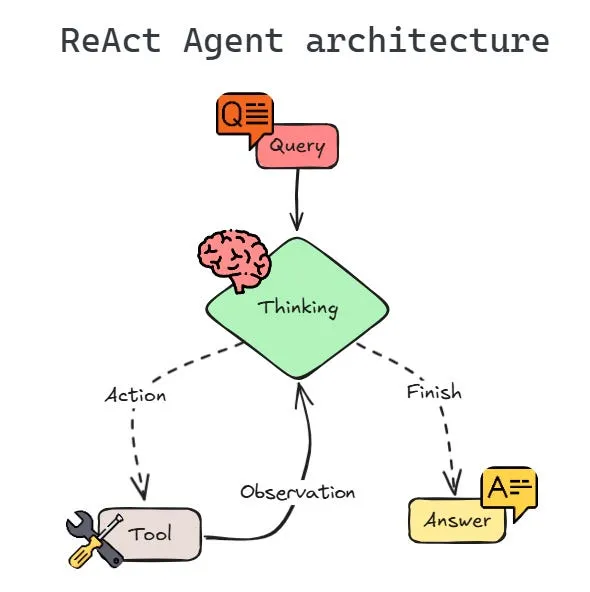
这 ReAct 流程图,如何映射到上面 Pi 的阶段呢?或者说,最重要的 LLM 大脑,参与了 Pi 的哪些阶段?
连接 LLM
什么时候发请求给 LLM?LLM 什么时候结束响应?
回答前,先判断几个直觉决策对不对:
- 一次 LLM 调用只在一个 turn 里完成,不跨 turn,生命周期符合层级。
- 在新的输入消息 (包括
user/tool-result) 加入后马上发请求,也就是在message_end{user/tool-result}事件后发请求,类似 chatbot。 - 收到完整新消息后,马上发
message_end事件,让上层 (UI) 能及时展示内容。
决策 3 是会影响用户体验的,所以要采纳。
这意味着执行完工具后要马上发 message_end{ toolResultMessage }。如果配合决策 2,就会在 turn_end 前发第二次请求,导致连接跨 turn。
所以 Pi 选择了 1,3 决策,在 turn_start 后,中间可能有 message_start/end{ userMessage },给 LLM 发请求。
然后 LLM 在 turn_end 前结束响应,也就是 message_end{ assistantMessage } 事件。
把事件顺序落实到代码里:
event_sink(AgentEvent::AgentStart)
let mut pending_prompts = prompts
let reason : LoopStopReason = for ;; {
  event_sink(AgentEvent::TurnStart)
  for prompt in pending_prompts {
    let msg = AgentMessage::User(prompt)
    messages.push(msg)
    event_sink(AgentEvent::MessageStart(msg))
    event_sink(AgentEvent::MessageEnd(msg))
  }
  pending_prompts = []
  let mut message_started = false
  let assistant_message = llm.generate({ system_prompt, messages, tools }, sink=event => {
    match event {
      Start(partial~) => {
        message_started = true
        let msg = AgentMessage::Assistant(partial)
        messages.push(msg)
        event_sink(AgentEvent::MessageStart(msg))
      }
      ...
    }
  }) catch {
    err => ...
  }
  let final_msg = AgentMessage::Assistant(assistant_message)
  if message_started {
    messages[messages.length() - 1] = final_msg
  } else {
    messages.push(final_msg)
    event_sink(AgentEvent::MessageStart(final_msg))
  }
  event_sink(AgentEvent::MessageEnd(final_msg))

  let tool_results = []
  match assistant_message.stop_reason {
    Aborted | Error => ()
    _ =>
      for content in assistant_message.content {
        guard content is AssistantMessageContent::ToolCall(tool_call, ..) else {
          continue
        }
        event_sink(AgentEvent::ToolExecutionStart(tool_call))
        let call_timestamp = @env.now()
        let update_sink = ...
        let result = tool_executor(tool_call, update_sink) catch {
          err =>
            {
              content: [InputMessageContent::Text(err.to_string())],
              details: {},
              is_error: true,
              terminate: false,
              usage: None,
            }
        }
        let tool_result = ToolResultMessage::{
          tool_call_id: tool_call.id,
          tool_name: tool_call.name,
          content: result.content,
          is_error: result.is_error,
          timestamp: call_timestamp,
          terminate: result.terminate,
        }
        event_sink(AgentEvent::ToolExecutionEnd(tool_result))
        tool_results.push(tool_result)
        messages.push(AgentMessage::ToolResult(tool_result))
      }
  }

  event_sink(AgentEvent::TurnEnd(assistant_message, tool_results))
  match assistant_message.stop_reason {
    Aborted => break Aborted
    Error => break Error
    _ => ()
  }
  if tool_results.length() > 0 {
    continue
  }
  break Stop
}
event_sink(AgentEvent::AgentEnd(messages))
reason
可以看出 turn 里不少步骤是不一定发生的,例如
message_start/end{ userMessage }。通常在第一轮发生。tool_execution_start/update/end。在AssistantMessage有ToolCall时发生。message_start/end{ toolResultMessage }。执行了ToolCall后发生。
有没有 message_start/end{ toolResultMessage } 也是判断 loop 要不要停下来时机:最后一个 turn 没有 tool result observation 要给 LLM。能不能简单说“执行了 Tool 就要继续请求 LLM”呢?通常可以,不过 Pi 支持工具主动 terminate loop,例如一个美化输出结果的工具 structured-output 就可以在执行返回结果后,不再请求 LLM。
这是一个可用的 AgentLoop,不过它缺少了流式输出,也就是没发 MessageStart 事件。
流式输出需要 LLM 配合,我们来定义 LLM 接口。
LLM
大语言生成模型,当然要支持“生成”,所以 LLM 要有 generate 方法:
pub(open) trait LLM {
  async fn generate(Self, Context, sink~ : async (GenerationEvent) -> Unit) -> AssistantMessage
}
输入包含系统指令、工具定义、上下文消息。
pub(all) struct Context {
  system_prompt : String
  messages : ArrayView[AgentMessage]
  tools : ArrayView[ToolDefinition]
}
输出包括流式事件和最终完整消息:
pub(all) enum GenerationEvent {
  Start(partial~ : AssistantMessage)
  TextStart(content_index~ : Int, partial~ : AssistantMessage)
  TextDelta(content_index~ : Int, delta~ : String, partial~ : AssistantMessage)
  TextEnd(content_index~ : Int, content~ : String, partial~ : AssistantMessage)
  ThinkingStart(content_index~ : Int, partial~ : AssistantMessage)
  ThinkingDelta(content_index~ : Int, delta~ : String, partial~ : AssistantMessage)
  ThinkingEnd(content_index~ : Int, content~ : String, partial~ : AssistantMessage)
  ToolCallStart(content_index~ : Int, partial~ : AssistantMessage)
  ToolCallDelta(content_index~ : Int, delta~ : String, partial~ : AssistantMessage)
  ToolCallEnd(content_index~ : Int, tool_call~ : ToolCall, partial~ : AssistantMessage)
}
GenerationEvent 里的 partial 是正在生成/积累的消息,方便上层使用方 (例如扩展) 读取,在 generate 完成后,返回一个完整的 AssistantMessage。
仔细看看交互。
怎么实现这个接口?这就要对接实际的 LLM API 了。
LLM API
对接 LLM API 要解决的问题,概念上讲,是如何把上层的 Agent Message lowering 到下层的 LLM dialect Message,以及反过来如何把 LLM dialect Message lift 回 Agent Message。
实践中,则是对齐 API 协议。
我们对接新一点的 OpenAI Responses API 协议,刚好学一下 OpenAI 对 Agent 新的理解。刚好国内 Deepseek 官方服务最近支持了 Responses API。
Responses API
Responses API 不少概念跟 Pi AgentMessage 是共通的,例如有不同来源/role 的 message,有 tool call/result,streaming 模式有 added/delta/done 事件。
比较大的区别是,Responses API message 除了 content 主内容,还加了不少 metadata。例如:
-
所有 message 都加了 id,甚至 tool call 有
call_id和id。 -
text message 有
phase("commentary"|"final_answer"|null),文档还强调:... dropping it can degrade performance.
Pi 主要的处理方法是加一个 signature json 字段,给 API Provider 自己看着用。
pub(all) enum AssistantMessageContent {
  Text(String, signature~ : Json)
  Thinking(String, signature~ : Json)
  ToolCall(ToolCall, signature~ : Json)
}
pub(all) struct ToolCall {
  id : String
  name : String
  arguments : Json
}
保留 metadata 和做好内容转换,对接 API 的工作就基本完成了,至于解析 SSE 流式响应就不展开讲了,只是简单的 key: value\n 格式。看 AgentLoop 的另一块,tool execution。
Tools
Tools 是 Agent 里对接杂乱现实的部分,同时也是玩具和有生产价值的 Agent 的区分点。 优化它就是在 harness LLM。
Pi 以极简主义出名,默认只启用 4 个 tool:read,write,edit,bash。 即便这样,也要优化工具,在各种情况下都给出长度合理,有信息量的结果。
Context Engineering
Pi 在管理 Tool Result Context 的主要措施有:
- 结果包含提示。
- 结果限制上限。
- 容错,自动转换。
举个例子,read tool 接受 path 文件路径和 offset,limit 按行范围读内容,简洁方案。
但它里面处理了:
- 行数/字节硬上限,防止污染上下文。
- 达到上限截断,给 LLM 截断后内容和提示。
offset,limit参数范围容错。- 识别图片和格式。
- 图片超大图自动缩放,给 LLM 缩放图和提示。
- LLM 不支持视觉时提示。
Pi 里 read 截断后给模型的提示就细分三种:
- 行数截断:
[Showing lines X-Y of Z. Use offset=N to continue.] - 字节截断:
[Showing lines X-Y of Z (50.0KB limit). Use offset=N to continue.] - 首行单独超过 50KB:
[Line N is XKB, exceeds 50.0KB limit. Use bash: sed -n 'Np' path \| head -c N]
我们没精力维护庞大的 edge-cases,又想做得不那么像玩具,可以用一个取巧的办法,就是把 Code Interpreter 给 LLM,让它用上现有工具生态和灵活组装工具。
我们给它经典的 Bash。OMP 作者给 Agent 提供了 Python 解释器,在 ARC-AGI-3 bench 上把 Opus 5 Max 成绩从 30.2% 提升到 97.4%。
Bash Tool
bash tool 没有比 read tool 复杂太多。只需要 command 和 timeout 参数。
Pi 处理了:
- stdout/stderr 和进程退出码。
bash 也要管理输出长度,不过它截断保留的是末尾部分,同时把完整输出写到临时文件,提示 LLM 可以“续读”。bash 通常有副作用,命令结果很重要。
Pi 用
OutputAccumulator流式存储结果。 - 进程树。
- 环境变量。注入一些
PI_*session 环境变量让 LLM 感知 Pi 环境。
支持了 tool execution,再给 LLM 提供 tool 信息就能用了。
Tool definitions
提供给 LLM 的 tool definitions,常见的是 Function Calling 形式,也就是 name,description,parameters (JSON Schema)。OpenAI 还支持 Hosted Tool,也就是 tool 不在 agent 端执行,而是在 LLM Provider 执行,例如 web_search。还有 Custom Tool,LLM 写普通 text 而不是 json,声明 regex/lark grammar 来限制 LLM 输出。
{
  "name": "bash",
  "description": "Execute a bash command in the current working directory. Returns stdout and stderr. Output is truncated to last 2000 lines or 50KB (whichever is hit first). If truncated, full output is saved to a temp file. Optionally provide a timeout in seconds.",
  "parameters": {
    "type": "object",
    "properties": {
      "command": {
        "type": "string",
        "description": "The bash command to execute"
      },
      "timeout": {
        "type": "integer",
        "description": "Optional timeout in seconds",
        "minimum": 1
      }
    },
    "required": ["command"],
    "additionalProperties": false
  }
}
在请求 LLM provider 时把 tool definitions 传入,在收到 tool call message 根据 name 找到对应的 tool,再解析 json 取到参数就可以执行了。
System Prompt
一个正常的 Agent 环境,想影响和预估 LLM 的行为,除了 Tools,就基本靠 System prompt。Claude Code 等 Agent 系统也会主动插入 <system-reminder> 这种信息 message 来影响 LLM 的行为。
看一下 Pi 的 System prompt:
You are an expert coding assistant...

Guidelines:
${guidelines}

Pi documentation...

<project_context>

Project-specific instructions and guidelines:

<project_instructions path="${filePath}">
${content}
</project_instructions>

</project_context>

The following skills provide specialized instructions...
<available_skills>
  <skill>
    <name>${escapeXml(skill.name)}</name>
    <description>${escapeXml(skill.description)}</description>
    <location>${escapeXml(skill.filePath)}</location>
  </skill>
</available_skills>
Current working directory: ${promptCwd}
大概分为:
- Agent 定位。
- 工具指南 (Guidelines)。
Pi 要提供优秀的扩展性,所以 tool 提供方可以在
ToolDefinition的promptGuidelines字段写一些指导和最佳实践给 LLM。 - (Pi) 环境信息。
- 用户的指令 (AGENTS.md)。
- Skills。支持 Skills 对 Agent 实现影响很小,在 System Prompt 里列出 Skills 信息和路径,提供读文件工具就能让 Agent 支持 Skills。 格式参考 agentskills.io。
- (项目) 环境信息。通常与任务更相关。
从 Loop 到应用
距离一个 real world 应用还差什么?
做最简单的 CLI 命令行工具,那至少要有输入、输出吧。
CLI -p
先写个 CLI。参考 Pi/Claude Code -p 参数,让用户可以执行非交互性任务。例如:
$ mypi -p "What's the capital of France? Respond with only the city name."
Paris
把最后的 message content 打印出来就行。
let session = @coding_agent.new_coding_session(llm, cwd~)
let mut last_message : @agent_loop.AgentMessage? = None
session.subscribe(event => {
  match event {
    Loop(MessageEnd(Assistant(_) as m)) => last_message = Some(m)
    _ => ()
  }
})
session.prompt(
  prompts.map(p => @agent_loop.UserMessage::{
    content: [@agent_loop.InputMessageContent::Text(p)],
  }),
)
guard last_message is Some(Assistant({ content, .. }))
let output = StringBuilder()
for part in content {
  match part {
    Text(text, ..) => output.write_string(text)
    _ => ()
  }
}
write_stdout(output.to_string())
多轮对话
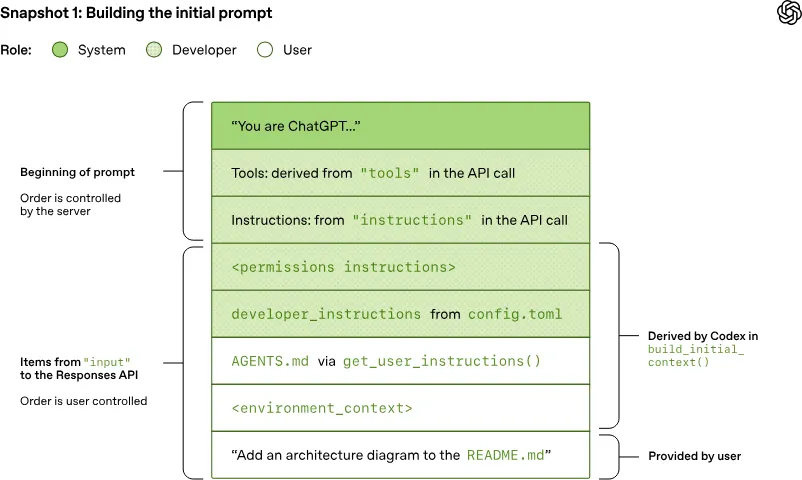
Agent 应用通常支持多轮对话 (称为 session 或者 thread),下面是 OpenAI 解释 Codex 的另一张图:注意跟 Pi AgentLoop 里更小的 turn 区分开来。OpenAI 说的 turn 是完整的一个 AgentLoop。
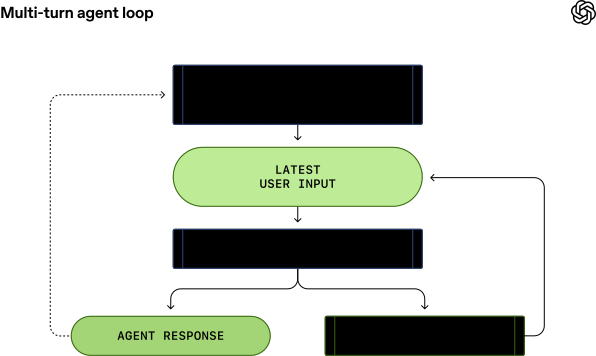
内层回环是 AgentLoop,由 Tool Result 驱动。 外层回环是 SessionLoop,由新的 User Input 驱动。
我们用一个 AgentSession 来管理,在多轮 AgentLoop 间复用同一个 message buffer 就能支持多轮对话。虽然 benchmark 通常不需要多轮对话,但最好有重试功能,而在 AgentLoop 上游 (Session) 和下游 (LLMProvider) 实现重试都更简洁干净。
pub struct AgentSession {
  journal : &SessionJournal
  llm : &@agent_loop.LLM
  tool_registry : @tools.ToolRegistry
  message_buffer : Array[@agent_loop.AgentMessage]
  system_prompt : String
  mut active_run_exists : Bool
}

pub async fn AgentSession::prompt(
  self : AgentSession,
  input : Array[@agent_loop.UserMessage],
) -> Unit {
  ...
  @agent_loop.run_agent_loop(
    self.llm,
    self.system_prompt,
    self.message_buffer,
    agent_tools,
    pending_prompts,
    tool_executor=(c, hook) => @tools.run_tool(tool_map, c, hook),
  )
  ...
}
Session Journal
Agent 应用通常还支持重启/继续某次对话,甚至分析 Agent 轨迹,所以要持久化 session。
session 常见持久化方案是 jsonl 文件,类似 Event Sourcing。 这里监听 AgentLoop 发的阶段事件 (Agent Events),找出 user/assistant/tool-result message,包一层追加写入 jsonl 文件。
@agent_loop.run_agent_loop(
  ...
  event_sink=event => {
    let content : SessionEntryContent? = match event {
      MessageEnd(User(_) as m) => Some(Message(m))
      MessageEnd(Assistant(_) as m) => Some(Message(m))
      ToolExecutionEnd(result) => Some(Message(ToolResult(result)))
      _ => None
    }
    if content is Some(content) {
      self.journal.append([{ id: self.journal.generate_id(), content }])
    }
  },
)1{"kind":"header","version":4,"id":"13980947","createdAt":1787111079566,"cwd":"/Users/xieziheng/projects/pi.mbt"}
{
  "kind": "header",
  "version": 4,
  "id": "13980947",
  "createdAt": 1787111079566,
  "cwd": "/Users/xieziheng/projects/pi.mbt"
}2{"kind":"entry","lane":"main","id":"18352111","seq":1,"parentId":null,"timestamp":1787111079568,"type":"message","message":{"role":"user","content":[{"type":"text","text":"What's the capital of France? Respond with only the city name."}]}}
{
  "kind": "entry",
  "lane": "main",
  "id": "18352111",
  "seq": 1,
  "parentId": null,
  "timestamp": 1787111079568,
  "type": "message",
  "message": {
    "role": "user",
    "content": [
      {
        "type": "text",
        "text": "What's the capital of France? Respond with only the city name."
      }
    ]
  }
}3{"kind":"entry","lane":"main","id":"10156916","seq":2,"parentId":"18352111","timestamp":1787111081854,"type":"message","message":{"role":"assistant","content":[{"type":"thinking","thinking":"The user asks for the capital of France and wants only the city name. This is a simple question.","thinkingSignature":"{\"type\":\"reasoning\",\"id\":\"2703a60b-8628-4d3b-a744-0f3c5d01b034\",\"status\":\"completed\",\"content\":[{\"type\":\"reasoning_text\",\"text\":\"The user asks for the capital of France and wants only the city name. This is a simple question.\"}],\"summary\":[],\"encrypted_content\":\"acb023de-1ceb-4623-a832-5f84dbce09df-0\"}"},{"type":"text","text":"Paris","textSignature":"{\"type\":\"message\",\"id\":\"2ce8b38f-f7af-40d0-9ba8-3f8252281ae0\",\"phase\":\"final_answer\"}"}],"api":"openai-responses","provider":"deepseek","model":"deepseek-v4-flash","stopReason":"stop","errorMessage":null,"usage":{"input":49,"output":23,"cacheRead":1664,"cacheWrite":0,"cacheWrite1h":null,"reasoning":21,"totalTokens":1736,"cost":{"input":0,"output":0,"cacheRead":0,"cacheWrite":0,"total":0}},"timestamp":1787111081321}}
{
  "kind": "entry",
  "lane": "main",
  "id": "10156916",
  "seq": 2,
  "parentId": "18352111",
  "timestamp": 1787111081854,
  "type": "message",
  "message": {
    "role": "assistant",
    "content": [
      {
        "type": "thinking",
        "thinking": "The user asks for the capital of France and wants only the city name. This is a simple question.",
        "thinkingSignature": "{\"type\":\"reasoning\",\"id\":\"2703a60b-8628-4d3b-a744-0f3c5d01b034\",\"status\":\"completed\",\"content\":[{\"type\":\"reasoning_text\",\"text\":\"The user asks for the capital of France and wants only the city name. This is a simple question.\"}],\"summary\":[],\"encrypted_content\":\"acb023de-1ceb-4623-a832-5f84dbce09df-0\"}"
      },
      {
        "type": "text",
        "text": "Paris",
        "textSignature": "{\"type\":\"message\",\"id\":\"2ce8b38f-f7af-40d0-9ba8-3f8252281ae0\",\"phase\":\"final_answer\"}"
      }
    ],
    "api": "openai-responses",
    "provider": "deepseek",
    "model": "deepseek-v4-flash",
    "stopReason": "stop",
    "errorMessage": null,
    "usage": {
      "input": 49,
      "output": 23,
      "cacheRead": 1664,
      "cacheWrite": 0,
      "cacheWrite1h": null,
      "reasoning": 21,
      "totalTokens": 1736,
      "cost": {
        "input": 0,
        "output": 0,
        "cacheRead": 0,
        "cacheWrite": 0,
        "total": 0
      }
    },
    "timestamp": 1787111081321
  }
}
Terminal Bench
是时候检验成果了。我们用 terminal-bench@2.1 验证,它里面的任务基本是给一个终端命令行,让 Agent 执行,然后验证结果是否正确。
terminal-bench 有官方运行器 harbor。 原理是按任务定义构建 docker 镜像,把 agent 执行程序放进去,用容器跑每个任务,记录日志和结果,用 test.sh 验证结果。 我们可以在本地跑 harbor,也可以节省时间去云端并发跑,例如去 (免费的) GitHub Actions。 模型我用 DeepSeek-V4-Flash,跑快一点。
最后结果:mypi 64/89 = 71.9% vs DeepSeek Harness 82.7%, -10.8% 的差距。
我 (让 K3) 分析了下 journal,发现不少任务超时,可能跟 GitHub Action 环境有关。 篇幅有限,我们把更严谨的 benchmark 和 Agent 优化作为下篇文章的内容吧。 这里看个曲折的 Agent 轨迹,一次 build-pov-ray 失败的轨迹,证明我们的 Agent Runtime 是可以支持长任务的:
- 这个任务要编译 1996 年的 POV-Ray 2.2,渲染样例场景 illum1.pov。
- Agent 要下载 POV-Ray 2.2,发现官网 povray.org 被 Cloudflare 拦了。
- 自己去 Wayback Machine 翻出当年的源码包,处理 CRLF 行尾和 ZIP 大写文件名,手写适配现代 gcc 的 makefile,编译通过,渲染结果达标。
- 然后因为没保留 ZIP 里一个
file_id.diz元数据小文件,被判 FAIL。
回顾
“人无法用 AI 做出自己不了解的东西”,在 2026 年 LLM AI 时代,多数时候都不成立了。 在做这 Agent 时,为了节省时间,我让 coding agent 帮我对接 Responses API 和对齐 Pi session jsonl,最终成品能正常跑过 benchmark。
但在写文章时,才发现自己在“AgentLoop 对接 Responses API”方面有理解错误,个人的知识边界变得模糊。回过头去看代码,与 AI 讨论,反而能找出几个 AI 写的 bug。 在做深、做大产品上,人的理解还是有加速 AI 产出和扩展 AI 能力边界的 (商业) 价值。
对个人来说,我也更喜欢理解身边的东西。如果理解计算机图形学,会更能欣赏下面的画吧。我为了拿渲染图重跑一遍 build-pov-ray,Agent 发现这份 1996 年的代码自带一个随机 bug (void main 导致退出码未定义),渲染成功也有 ~25% 概率返回错误退出码 53。它顺手修掉后通过了 benchmark verifier。